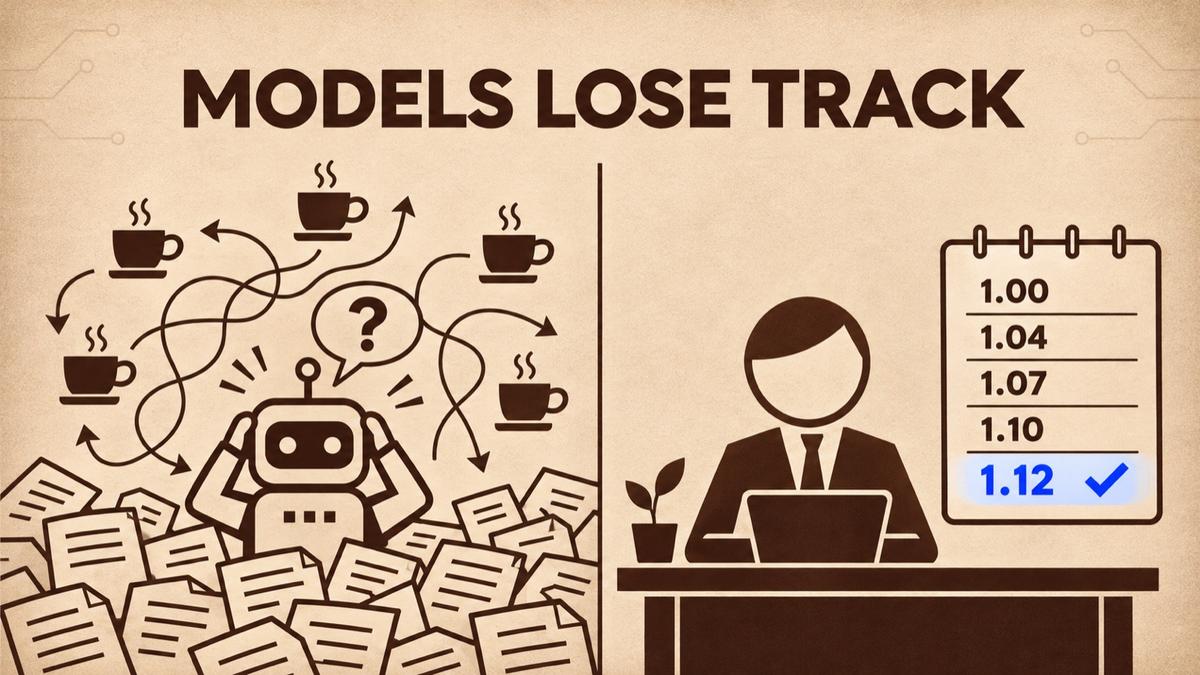
13% ou moins : la semaine où Ai2 a montré que les IA perdent le fil des longs documents
L'institut de recherche Ai2 a publié le 3 novembre 2026 StateBench, un test ouvert qui mesure si un modèle suit les changements d'état dans un long document : Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna y tombent à 13% de bonnes réponses ou moins sur les cas les plus longs et les plus difficiles. La même semaine, Google a chiffré le vol de comptes d'IA dans le cloud, et AMD, Fal et Sentra ont montré où va l'argent.
- Ai2 a publié le 3 novembre 2026 StateBench, un banc d'essai sous licence Apache-2.0 qui teste le suivi d'informations qui changent au fil d'un long document.
- Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna réussissent les mises à jour simples mais descendent à 13% ou moins sur les échanges de valeurs les plus longs de StateBench.
- Le benchmark VagueBench, publié le 2 novembre 2026, mesure une baisse relative de 19,65% du taux de réussite d'agents IA quand la consigne manque de contexte.
- Google Threat Intelligence a décrit le 3 novembre 2026 des vols de comptes d'IA dans le cloud qui ont coûté plus de 100 000 $ en une journée à certaines victimes.
- AMD a annoncé le 3 novembre 2026 un chiffre d'affaires trimestriel de 13,4 Md$, dont 8,5 Md$ pour les centres de données, en hausse de 97% sur un an.
Que mesure StateBench, le test publié par Ai2 le 3 novembre 2026 ?
Ai2 a publié le 3 novembre 2026 StateBench, un banc d'essai qui vérifie si un modèle de langage suit correctement une information qui change au fil d'un long document. Le principe est simple à expliquer : le modèle lit une longue suite d'affectations de variables, puis il doit donner la valeur finale de chacune. Les auteurs illustrent l'idée par une enquête policière : « John a donné le couteau à Mary » est facile à retenir, mais « John a donné à Mary l'objet de son sac, sachant qu'Edward avait glissé un couteau dans ce sac » oblige à reconstituer une chaîne d'événements.
Le travail est signé Jackson Petty, William Merrill et Ashish Sabharwal dans un article déposé sur arXiv le 2 novembre 2026. Le code est publié sur GitHub sous licence Apache-2.0 et le jeu de données sur Hugging Face, avec environ 68 000 exemples. La série de test par défaut monte jusqu'à 64 000 affectations, avec des documents qui restent sous un million de tokens environ.
L'intérêt pour un utilisateur non chercheur tient à la nature de la tâche. Suivre qui détient quoi, quel prix a été modifié en dernier ou quel article d'un contrat a remplacé l'autre, c'est exactement ce qu'on demande à un assistant IA quand on lui confie un long dossier. StateBench ne mesure pas la culture générale d'un modèle, il mesure sa capacité à tenir les comptes sur la durée, ce qui est un angle mort des classements habituels.
Pourquoi les grands modèles réussissent-ils les mises à jour simples mais pas les échanges ?
Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna obtiennent de bons résultats sur les deux premiers niveaux de StateBench, mais leur précision chute à 13% ou moins sur les plus longs problèmes du quatrième niveau, selon Ai2 (3 novembre 2026). Les quatre niveaux suivent une logique progressive. Le premier ne demande que la valeur initiale, comme une date de naissance qui ne change jamais. Le deuxième demande la valeur la plus récente, comme le réglage d'un thermostat. Le troisième impose de cumuler des mises à jour, comme un score de match. Le quatrième, le plus dur, fonctionne par référence : une variable prend la valeur d'une autre, ou deux variables s'échangent, à la manière d'un bonneteau à cinq gobelets.
Le document garde le même nombre de variables et de valeurs à chaque niveau. Seule la nature des affectations change, ce qui isole bien la difficulté. Les modèles ouverts testés par Ai2 (Olmo 3 et Olmo Hybrid en 7 milliards de paramètres) restent au niveau du hasard sur le quatrième niveau.
Les auteurs ont aussi entraîné depuis zéro de petits modèles de 275 millions de paramètres. Les architectures récurrentes de type Gated DeltaNet et les hybrides généralisent presque parfaitement sur les trois premiers niveaux, jusqu'à des dizaines de milliers d'affectations. Les transformers, l'architecture de la plupart des assistants actuels, apprennent les niveaux faciles mais ne parviennent jamais à apprendre le quatrième. Pour Ai2, le benchmark doit servir de cap à de nouvelles architectures, pas de verdict définitif sur les produits du marché.
Une consigne vague suffit-elle à dérouter un agent IA ?
Une équipe de dix chercheurs menée par Yang Qu a mesuré, dans VagueBench publié le 2 novembre 2026, une baisse relative de 19,65% du taux de réussite de six agents IA quand les consignes perdent leur contexte. Le même test relève une hausse relative de 54,10% des plans vides, c'est-à-dire des cas où l'agent ne propose aucune action. Le banc d'essai compte 1 303 paires de consignes réparties en 4 catégories, dans l'environnement de simulation domestique AI2-THOR.
VagueBench porte sur des agents incarnés, qui manipulent des objets dans une maison virtuelle, mais la leçon dépasse la robotique. Un agent reçoit rarement une consigne complète dans la vraie vie. « Range ça » ou « prépare le dossier du client » supposent que l'agent comble les trous avec le contexte, et c'est précisément là que la performance s'effondre.
Rapproché de StateBench, le résultat dessine une même faiblesse : les modèles brillent sur des tâches bien définies et courtes, puis décrochent quand il faut retenir ou deviner ce qui n'est pas écrit noir sur blanc. Le développeur Simon Willison a montré le 3 novembre 2026 l'autre face de la médaille : Qwen 3.8 27B, lancé en local sur son ordinateur portable via LM Studio (fichier d'environ 17 Go), a reconnu trois jeux vidéo sur quatre à partir des seuls poids d'un petit réseau de neurones. Il lui a fallu entre 46 minutes et plus d'une heure par jeu, ce qui rappelle qu'un modèle ouvert local peut raisonner loin, à condition d'avoir du temps et un contexte bien posé.
Combien coûte un compte d'IA volé dans le cloud ?
Google Threat Intelligence a décrit le 3 novembre 2026 des attaques de « LLMjacking » où des pirates utilisent des comptes d'IA volés dans le cloud, avec des factures frauduleuses de plus de 100 000 $ en une seule journée et jusqu'à 1 million de dollars cumulés chez certaines victimes. Le rapport de Google détaille la mécanique : les attaquants récupèrent des clés d'accès aux modèles hébergés, vérifient qu'elles fonctionnent par des requêtes minuscules, puis revendent l'accès.
Un service de revente nommé Jet Night a fait passer plus de 500 000 appels d'API en moins de huit heures sur le compte d'une victime, pour près d'un million de dollars de tokens. Le service proposait un abonnement illimité à environ 60 $ par mois, nettement sous les 100 à 250 $ d'un abonnement légitime. Les attaquants ont aussi exploité une faille de LiteLLM, une passerelle open source très utilisée pour router les appels vers plusieurs modèles, référencée CVE-2026-40217, pour obtenir les droits d'administration.
Ce sujet concerne directement les petites structures qui branchent un modèle dans un outil interne ou un automate n8n. Une clé d'API oubliée dans un fichier partagé ou un dépôt de code devient une carte bancaire ouverte. Google recommande des clés aux droits limités, des alertes et plafonds de dépense, une authentification résistante au phishing et la mise à jour rapide des passerelles comme LiteLLM. Les journaux d'appels aux modèles doivent être surveillés comme ceux d'un compte bancaire.
Qui finance la couche de calcul de l'IA cette semaine ?
AMD a annoncé le 3 novembre 2026 un chiffre d'affaires trimestriel de 13,4 Md$, en hausse de 45% sur un an, dont 8,5 Md$ pour l'activité centres de données, en hausse de 97%, selon son communiqué déposé auprès de la SEC. Le fabricant prévoit environ 17 Md$ au quatrième trimestre. Il indique qu'Anthropic, Meta, Microsoft, OpenAI et Oracle Cloud font déjà tourner des charges sur ses premières baies Helios.
Le détail le plus parlant se trouve dans les comptes : AMD enregistre une variation de 1 097 M$ de la juste valeur de bons de souscription d'actions accordés à des clients. Concrètement, une partie de la croissance du fabricant de puces s'accompagne d'une promesse de capital à ses plus gros acheteurs, à mesure qu'ils commandent. Ce montage circulaire reste un point de vigilance pour lire les chiffres du secteur.
Plus en aval, Fal, spécialiste de l'inférence d'images et de vidéos, a levé 1,3 Md$ pour une valorisation de 16 Md$, le double d'avril, avec Bessemer en tête et NVIDIA au tour de table, selon TechCrunch le 3 novembre 2026. Côté sécurité, Sentra a levé 150 M$ en série C menée par Capital One Ventures, selon SecurityWeek le 4 novembre 2026, pour protéger les données que les agents IA manipulent. L'argent suit donc trois couches : les puces, le service d'inférence et la protection des données.
Que doit vérifier une PME qui confie de longs dossiers à une IA ?
Les résultats de StateBench, publiés par Ai2 le 3 novembre 2026, invitent une PME à ne jamais demander à un assistant IA la « version finale » d'une information qui a changé plusieurs fois dans un long document sans contrôle humain. Un historique de devis, un contrat avec avenants successifs ou un fil d'e-mails où une date de livraison a bougé trois fois sont typiquement des tâches de suivi d'état. Le modèle peut y répondre avec aplomb et se tromper.
Quatre réflexes limitent le risque. D'abord, découper : demander à l'IA de lister chaque modification dans l'ordre, avec sa source, plutôt que de livrer directement le résultat final. Ensuite, réduire : donner le dernier avenant et le contrat d'origine plutôt que tout le fil. Puis préciser : une consigne qui dit quoi chercher et dans quel document, ce que confirme VagueBench. Enfin, sécuriser les accès : des clés d'API à droits limités, avec un plafond de dépense, comme le recommande Google après les vols de comptes décrits le 3 novembre 2026.
Aucun de ces gestes ne demande de compétence technique avancée. Ils transforment l'IA en assistant qui prépare et justifie, et laissent à un humain la décision sur les chiffres qui engagent l'entreprise. C'est la façon la plus sûre d'en tirer le gain de temps sans en payer les erreurs.
Testez votre lecture de la semaine
Que mesure StateBench, publié par Ai2 le 3 novembre 2026 ?
Jusqu'où tombent les modèles de pointe sur les plus longs problèmes du niveau le plus difficile de StateBench ?
Quelle baisse relative du taux de réussite VagueBench mesure-t-il quand la consigne manque de contexte ?
Combien d'appels d'API le service Jet Night a-t-il fait passer en moins de huit heures sur le compte d'une victime ?
Quel a été le chiffre d'affaires de l'activité centres de données d'AMD au troisième trimestre 2026 ?
Sources
- Ai2 (Hugging Face), StateBench: Testing how language models track state changes over long documents, 3 novembre 2026
- arXiv, Petty, Merrill, Sabharwal, A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, 2 novembre 2026
- GitHub, allenai/state-bench, novembre 2026
- arXiv, Qu et al., VagueBench, 2 novembre 2026
- Simon Willison, Qwen 3.8 27B on my laptop can interpret model weights, too, 3 novembre 2026
- Google Threat Intelligence, The Rise of LLMJacking, 3 novembre 2026
- AMD (SEC), AMD Reports Third Quarter 2026 Financial Results, 3 novembre 2026
- TechCrunch, AI inference startup Fal doubles its valuation to 16B, 3 novembre 2026
- SecurityWeek, Agentic Data Security Firm Sentra Raises 150 Million, 4 novembre 2026
- Apple Developer, Siri AI integration developer preview, 4 novembre 2026
- LangChain, LangSmith Bring Your Own Cloud, novembre 2026
Pour aller plus loin
Pour recevoir chaque lundi trois actus IA triées pour les dirigeants, inscrivez-vous à la newsletter. Pour apprendre à confier de longs dossiers à une IA sans perdre le contrôle, découvrez les formations gratuites d'Agentia Academy.