OpenAI, NVIDIA, Groq : la guerre du silicium d’inférence rebat les cartes
En une semaine, OpenAI a officialisé sa première puce, NVIDIA a absorbé la stack Groq pour 20 Md$, et Anthropic a siphonné trois chercheurs clés de Google DeepMind. La pile d’inférence se réorganise plus vite que les calendriers capex des hyperscalers.
- OpenAI et Broadcom officialisent « Jalapeño », premier ASIC maison d’OpenAI — prototype fin 2026, plein régime S1 2028.
- NVIDIA licencie la techno Groq pour environ 20 Md$, Groq lève 650 M$ en parallèle.
- Qualcomm rachète Modular pour environ 4 Md$, soit près de 3× la valo de septembre 2025.
- Anthropic recrute Jonas Adler, Alexander Pritzel et John Jumper depuis Google DeepMind.
- Mistral fusionne Le Chat et son agent code dans une marque unique « Vibe », GLM-5.2 prend la tête du coding open source.
Jalapeño : pourquoi OpenAI veut sa propre puce
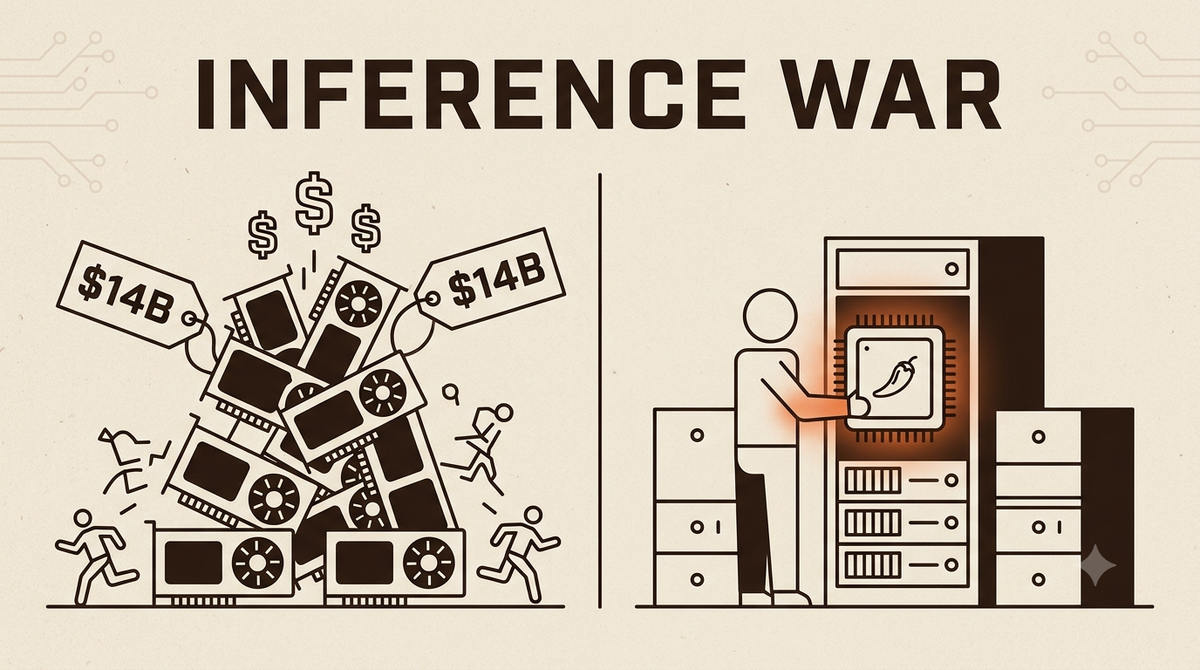
OpenAI a confirmé le 24 juin 2026 le co-design avec Broadcom de Jalapeño, son premier ASIC d’inférence. Le calendrier annoncé est sobre : premier prototype déployé en datacenter d’ici fin 2026, montée en cadence en 2027, plein régime au S1 2028. La logique économique tient en un chiffre que rappelle Broadcom dans la communication officielle : OpenAI a dépensé environ 14 Md$ en GPU tiers pour servir ChatGPT en 2025. À cette échelle, toute baisse durable du coût d’inférence, même de 30%, change le seuil de rentabilité du produit grand public.
La lecture stratégique est plus intéressante. ChatGPT est devenu un produit à trafic stable dont l’unit economics dépend des marges hardware. En désintéressant progressivement sa pile d’inférence de NVIDIA, OpenAI suit le schéma déjà mis en place par Amazon (Trainium), Google (TPU) et Meta (MTIA). Reste une inconnue : Broadcom est un partenaire de design, pas un fondeur. Le risque industriel se loge dans la chaîne TSMC, sur des nœuds 3 nm déjà saturés par Apple, AMD et NVIDIA. Le calendrier 2028 ne tient que si OpenAI a sanctuarisé ses wafers dès 2026. Couplé au filing IPO imminent valorisé environ 730 Md$, Jalapeño n’est pas un side-project : c’est un argument de prospectus avant l’ouverture du capital.
NVIDIA verrouille Groq sans le racheter : lecture d’un deal à 20 Md$
NVIDIA a confirmé en juin 2026 un accord de licensing non-exclusif avec Groq, valorisé autour de 20 Md$. La prochaine plateforme LPX de NVIDIA intègrera des briques de l’architecture LPU de Groq. Dans la même semaine, Groq annonce 650 M$ de financement growth, mené par Disruptive et Infinitum, avec un objectif de 200 MW de capacité déployée d’ici fin 2027. Pourquoi licencier plutôt qu’acquérir ? Trois raisons.
D’abord, le contexte antitrust. La FTC examine déjà la concentration verticale dans le silicium AI. Un rachat aurait déclenché un blocage probable. Ensuite, l’adéquation d’usage : Groq excelle sur des charges d’inférence latence-critiques (chat temps réel, agents), pas sur le training. NVIDIA garde la méga-marge sur le training H200 / Blackwell, et capte une option sur le segment inférence basse latence où ses GPU sont sous-optimaux. Enfin, NVIDIA préserve un partenaire indépendant qui continue de vendre à AWS, Aramco et Meta, ce qui élargit le marché total adressable de la techno sans cannibaliser les ventes GPU. Pour Groq, c’est la fin de la trajectoire « david contre goliath » : l’entreprise devient un fournisseur de stack intégré à l’écosystème NVIDIA, avec un « exit progressif » que peu de fonds avaient anticipé.
Talents IA : Anthropic et OpenAI continuent de vider Google DeepMind
La semaine du 22 juin a vu deux mouvements de talents simultanés. Noam Shazeer, chez Google depuis 2000 (à l’exception du détour Character.AI), quitte l’entreprise pour OpenAI. En face, Anthropic recrute Jonas Adler et Alexander Pritzel, deux contributeurs clés de Gemini, ainsi que John Jumper, co-auteur d’AlphaFold et directeur chez Google DeepMind. Trois départs de niveau senior staff en sept jours.
Le schéma rappelle 2019-2021, quand Google avait vu partir une vague de chercheurs vers OpenAI et Anthropic. Aujourd’hui, l’asymétrie s’est inscrite : Google paie au prix du marché, mais ne peut plus offrir la même décision d’allocation compute qu’Anthropic, qui injecte la quasi-totalité de ses 8 Md$ de financement Amazon dans l’entraînement Claude. La question est moins salariale qu’opérationnelle : un chercheur senior veut un cluster dédié, des cycles d’expérimentation courts, et une feuille de route modèle qu’il peut influencer. Sur ces trois axes, Anthropic et OpenAI gardent un avantage structurel sur Google, dont la gouvernance produit reste partagée entre DeepMind, Cloud, Search et Workspace. Google a annoncé en interne une réorganisation Gemini la semaine du 22 juin pour clarifier la chaîne de décision, sans en préciser les contours publics.
Open source : GLM-5.2, Kimi K2.7 et Nemotron 3 redessinent le coding
Juin a livré une vague open-weights compacte mais notable. GLM-5.2, sorti par Z.ai, prend la tête du coding open source avec 79,65 sur le Coding Avg et 73,33 sur l’Agentic Coding Avg, devant Llama 4 et Qwen 3.5 sur ces deux métriques. Kimi K2.7 Code HighSpeed (Moonshot) revendique 6× la vitesse d’inférence multimodale code à qualité comparable. Nemotron 3 Ultra, livré par NVIDIA, est salué par Sebastian Raschka pour son ratio capacité / efficience. VibeThinker-3B, fine-tune Qwen2.5-Coder-3B publié par WeiboAI sous licence MIT, atteint la parité avec les reasoners frontaliers sur math et code — à seulement 3 milliards de paramètres.
Trois conséquences pratiques. Premièrement, pour un développeur solo qui ne veut pas dépenser en API, le combo Kimi K2.7 + GLM-5.2 servi via vLLM ou Ollama couvre 80% des cas d’usage Cursor / Codex sans frais récurrents. Deuxièmement, l’écart entre frontier propriétaire et top open source sur le coding s’est réduit sous les 5 points de score agentic, contre 15 points il y a un an. Troisièmement, les acteurs B2B sensibles à la souveraineté données (banque, santé, défense européenne) disposent enfin de modèles locaux quasi-compétitifs sans dépendre d’une API US. Cette dernière fenêtre se ferme rapidement si la roadmap OpenAI o5 / GPT-5.5 reprend de l’avance au S2 2026.
Mistral fusionne dans Vibe, xAI emballe Grok pour le bureau
Mistral a annoncé en juin la fusion de Le Chat et de son offre code dans une marque produit unique : Vibe. Un agent, une licence, transition transparente des conversations et réglages existants. Côté modèles, Mistral pousse Medium 3.5, un dense 128B qui unifie instruction-following, reasoning et coding. C’est le premier acteur frontier à assumer publiquement la convergence chat + agent + IDE dans un seul produit grand public — un pari produit que ni OpenAI ni Anthropic ne tiennent encore en une marque unique.
xAI a, de son côté, multiplié les releases en quatre semaines. Grok 4.3 est généralement disponible sur Amazon Bedrock avec un contexte 1M tokens et le plus bas taux d’hallucination revendiqué sur les benchmarks frontier. Le mode /goal en Grok Build permet l’exécution autonome longue durée, avec controls pause / resume / status. L’add-in Grok pour Microsoft Word est gratuit, intègre Sharepoint, Google Drive et X comme sources, et réécrit ou génère des contenus directement dans le document. Enfin, Grok Imagine Video 1.5 est généralisé sur API et apps mobiles. La stratégie : capter l’utilisateur entreprise via Microsoft 365 et l’utilisateur créatif via le mobile, en parallèle du combat frontier sur le LLM. Trois canaux, un seul modèle.
Cursor 3.7, Copilot usage-based : le pricing flat est mort
Le 1er juin 2026, GitHub Copilot a basculé tous ses plans en usage-based avec les GitHub AI Credits. Allocation mensuelle incluse, surplus facturé en fin de mois. Fable 5 est généralisé depuis le 9 juin sur Pro+, Max, Business et Enterprise. La même semaine, Cursor a livré la 3.7 avec Composer 2.5 en mode agentic parallèle, exécution sur VMs cloud dédiées, intégrations Slack et GitHub natives, plus un modèle Tab maison.
Le constat est dur pour les abonnements flat à 10 ou 20 $ par mois : ils ne tiennent plus la charge compute des agents. Un développeur sérieux qui déclenche 8 à 12 sessions Composer par jour consomme entre 60 et 200 $ de compute par mois — quel que soit l’outil. Claude Code (Anthropic) tient l’entry tier à environ 20 $ avec usage layer au-dessus, et le Max plan dépasse largement les 100 $. Cursor Pro reste à 20 $ avec dépassement facturé. La grille tarifaire converge donc vers un modèle hybride identique chez Cursor, Anthropic, OpenAI et GitHub. Pour l’utilisateur, la conséquence est concrète : il faut budgéter la facture mensuelle agent comme un poste de capex, et choisir l’outil en fonction de la stack agentic (parallélisme, VM, intégrations) plutôt que du prix sticker.
Testez votre lecture de la semaine
Quel est le calendrier officiel de la puce Jalapeño d’OpenAI ?
Pourquoi NVIDIA a-t-il préféré licencier Groq plutôt que de l’acquérir ?
Combien Qualcomm paie-t-il pour acquérir Modular ?
Quel modèle open source revendique 79,65 sur le Coding Avg en juin 2026 ?
Quelle marque produit unique remplace Le Chat chez Mistral ?